
数値が判断に使いにくいのには理由があります。
- 上位のモデルが満点近くに張り付いて差が出ない。関数単位のコード生成を見る古いベンチマークで起きています
- 問題が学習データに混ざっている可能性がある。長く使われた問題ほど疑いが強くなります
- 測定の条件で数値が変わる。Terminal-Bench 4.0 の Claude Opus 5.5 は、Anthropic の公表値が 66.4 パーセント、第三者の測定値が 59.6 パーセントですが、思考にかける計算量の設定も実行環境も違う条件どうしの比較です(2026年9月時点)
社内で検証しようとすると人の時間がかかります。担当者が触って確かめる形だと、その担当者が忙しい月は検証ごと飛び、判断の根拠も残りません。
私がやったこと
手元で同じお題を回して比べるベンチマークを用意しました。
- 採点基準ごと公開されている既存のお題を借りた。回転する七角形の中で番号つきのボール20個を跳ねさせる、KCORES のお題です
- 結果を画像と動画で見比べられるように、元の Python を HTML と Canvas(ブラウザ上に図形を描く仕組み)に置き換えた
- Claude Code のサブエージェント(同じツールから別のモデルを呼び出す機能)で指定できる haiku、sonnet、opus、fable の4つに同じプロンプトを1回ずつ投げた
- 学習データの影響を見るため、七角形を八角形に、ボールを15個に入れ替えた版も並行して回した
モデルの自己申告をそのまま信じないことが要点です。下位のモデルほど、問題が残っていても問題なしと報告してきます。
対応方針
採点基準が公開されているお題を借りた理由
自分で採点基準を作ると、見た目の好みが点数に入ります。KCORES のお題には18項目それぞれ5点の基準が公開されているので、比較の軸を自分で決めずに済みます。元のお題は Python で描画するものでしたが、結果を並べて見せるには画像と動画が早いので HTML と Canvas に置き換えました。
手元のベンチマークのお題に求める条件
長く続いているお題の共通点に寄せます。
- お題とプロンプトと実行環境を固定して使い回せる
- 正解が一つに決まらない。点数の上限がないので上位のモデルでも差が出ます
- 結果を画像か動画で並べられる
- 手順が長い。一往復で終わるお題は上位のモデルが全部正解し、比較表と同じ理由で差が消えます
- 計算量の設定、所要時間、費用、何回目の試行かを一緒に記録できる
- 一度のタスクを解けるかを見る内容にする。社内のレビュー体制や規約に沿い続けられるかという、時間の経過を含む品質は測れません
学習データへの混入を確かめる入れ替え版
条件の数字や名詞を1つ入れ替えた版を用意し、元の版と同時に回します。両方の点数が近ければ、そのお題は特定の形を覚えているわけではないと言えます。
有名なお題ほど、モデル側がそれに合わせて作られている可能性が出るためです。ペリカンが自転車に乗る絵を描かせるお題では、開発元がこれに最適化しているのではないかという疑いが出て、Dylan Castillo 氏が動物と乗り物の48通りを7つのモデルで比べ、特別にうまく描ける証拠は見つからなかったと報告しています(2026年9月26日確認)。
出力を人の目で確認する工程
プロンプトの末尾に、完成前にモデル自身がブラウザで開いて確認して直すことと、確認できなかった項目はそう明記することを指示しています。この2行は宝玉氏のプロンプトから借りたもので、検収の手順まで書いておくと、自分で確かめて直せるかも比較の対象になります。ただし下位のモデルはこの指示を入れても正しく報告せず、問題なしという報告と動画を再生して見た状態が食い違いました。
具体的な使い方
新しいモデルが出た日の確かめ方
固定したプロンプトを複数のモデルへ同時に投げます。今回は haiku、sonnet、opus、fable に1回ずつ投げ、所要時間を記録しました。
出てきた HTML をブラウザで開き、4つを並べて同時に再生します。静止画では動きの破綻が見えないので、同じ時刻の4コマと動画の両方を残します。
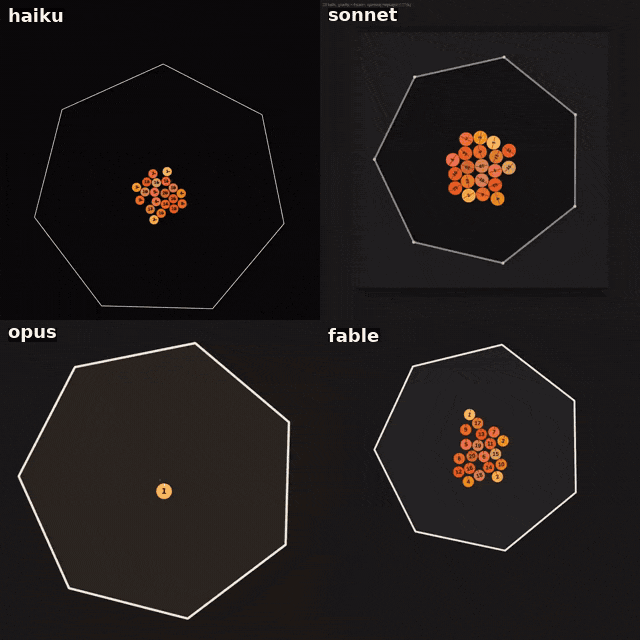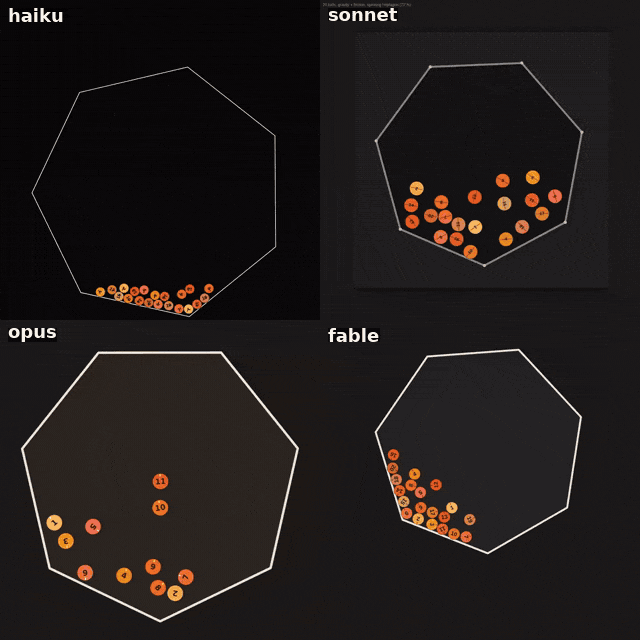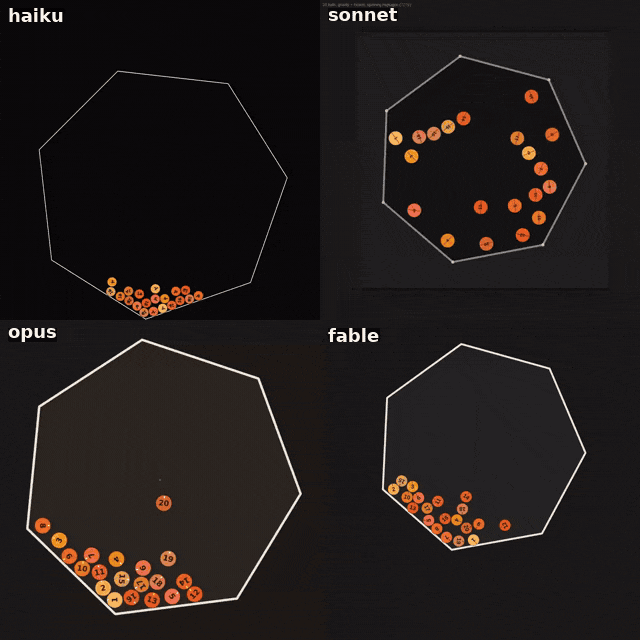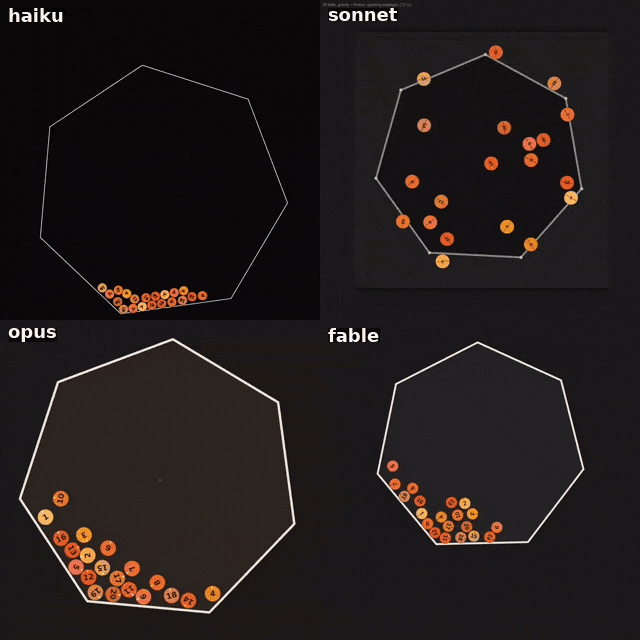
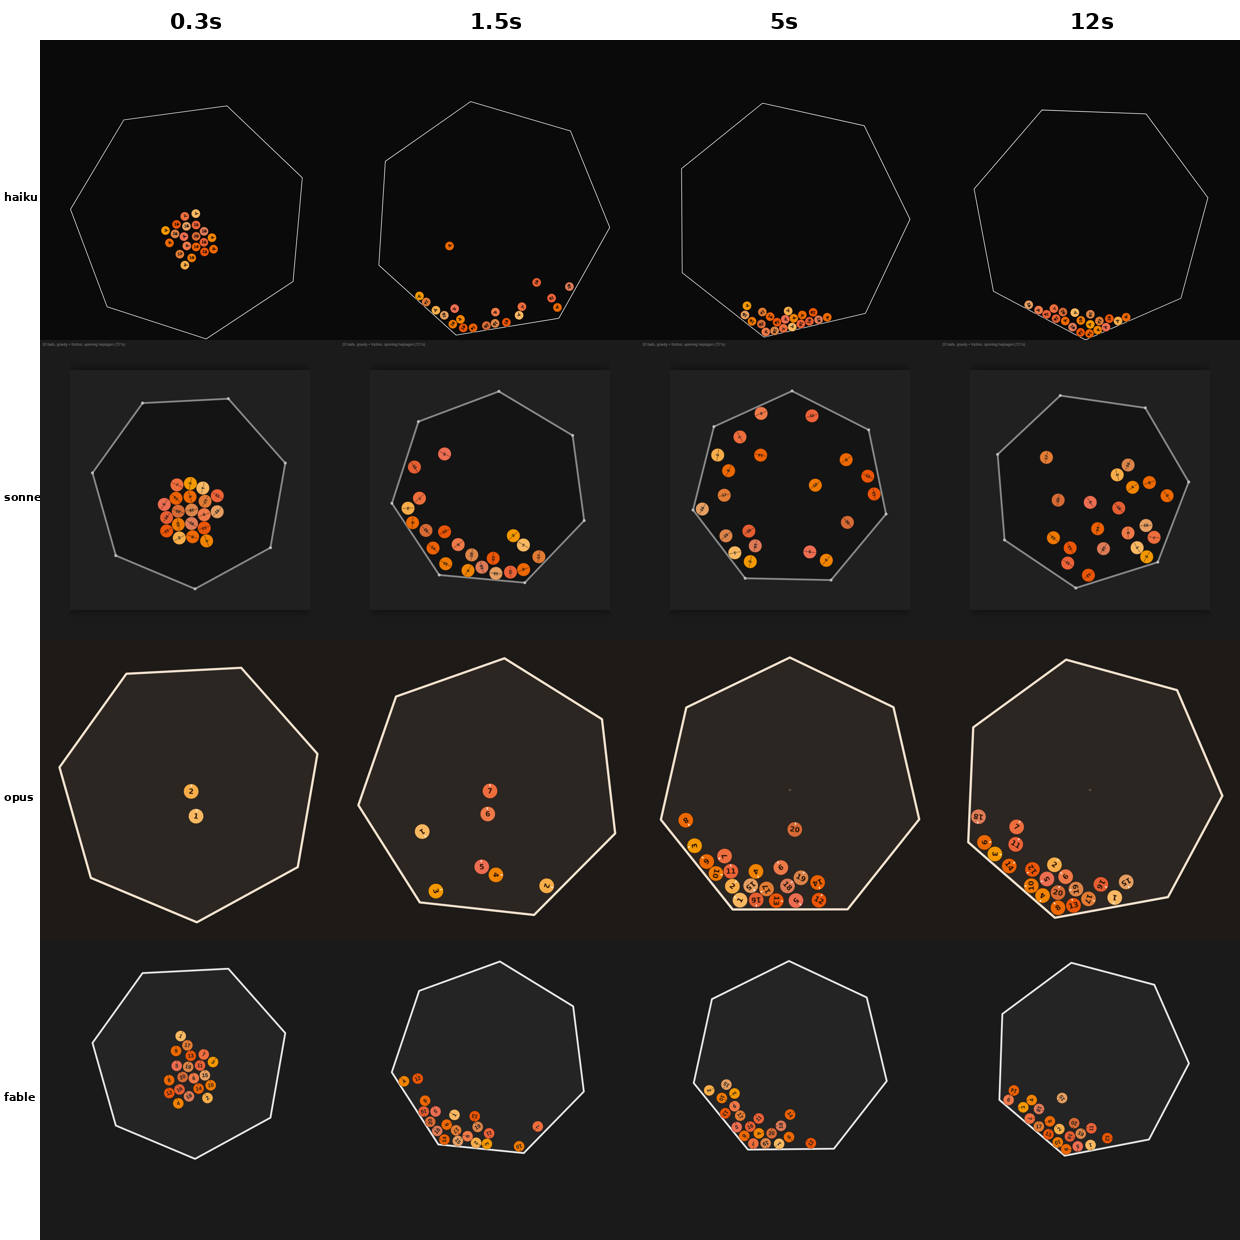
そのうえで KCORES の18項目で採点します。回転の摩擦、弾み方、見た目は画像を見ての判定のため AI に採点させました。人の目でつけた点数ではないため、小さな差は読めません。
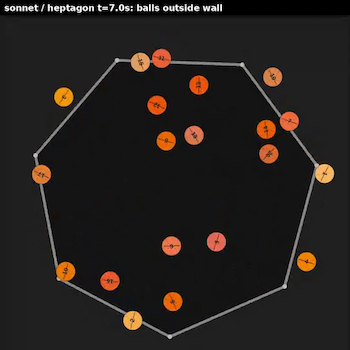
点数が近いときは動画を再生し直して破綻を探します。sonnet は60秒回して壁抜けなしと報告しましたが、8回再生すると1回、7秒前後でボールが何個も外に出ました。haiku の八角形でも同じです。
最後に七角形と八角形の点数を見比べ、片方だけ低ければ学習データの影響が疑われます。
ここまで一度通すと、どのモデルにどの作業を回すかをその日のうちに決められます。担当者が触って感触を確かめる形では、確かめ方も結果も残りません。
下位のモデルの限界を測る使い方
下位のモデルにも同じお題を投げると、費用を下げられる範囲が分かります。
| モデル | 七角形 | 八角形 | 所要時間(七角形) |
|---|---|---|---|
| haiku | 88 | 78 | 29分06秒 |
| sonnet | 81 | 85 | 3分42秒 |
| opus | 88 | 90 | 4分12秒 |
| fable | 88 | 88 | 4分47秒 |
haiku の七角形は88点で opus や fable と並びましたが、所要時間は29分06秒と、4分前後だった他の3つの7倍かかりました。点数だけでは差が出ないため、所要時間を記録していないとこの判断はできません。八角形では78点まで落ち、条件を入れ替えると10点の開きが出ています。
どの作業をどのモデルに寄せるかはお題ごとに変わります。ここで決まるのは、完成度が同じなら待ち時間の短いほうを選ぶ、という材料までです。
モデルごとの得意不得意をつかむ使い方
3D表現や描画のお題で強いモデルが、保守作業や資料作成でも強いとは限りません。お題の分野を変えて同じ比較をすると、その偏りが見えます。
公開されているお題自体も偏っています。3D表現ではBlender で城を作らせるお題、アルゴリズムでは回転七角形ボールやPolyglot ベンチマークが使われる一方、保守作業はSWE-Chainのような学術研究が中心で、手元で回せるものは多くありません。
ベンチマークを作らずに実務で試す分野の見分け方
資料作成や日次の事務では、モデル単体を比べるお題が見当たりませんでした。プレゼン作成ツール13個を同じ一文で並べた比較はありますが、製品どうしの比較です。Every の記事も、標準のベンチマークより自分の実務で比べたほうがよいと書いています(2026年9月26日確認)。
お題が育たないのは、必要なものが企業ごとに違いすぎるためです。社内の資料の型に合わせたいのか登壇用のスライドがほしいのかで、使うべき道具が変わります。
自分の業務に近いお題が無いと分かれば、ベンチマークを作らずに実務でそのまま試すほうへ切り替えられます。
手順
手元でベンチマークを用意する手順です。
1. 採点基準のあるお題を選ぶ
採点基準ごと公開されているお題を探します。基準がなければ観点を先に書き出します。あとから作ると、出てきたものに合わせた基準になります。
2. 結果を記録しやすい形に置き換える
画像と動画で並べられる形にします。お題が Python やデスクトップアプリを指定している場合、HTML に置き換えると画面の取り込みが楽です。替えるのは出力の形だけです。
3. 条件を入れ替えた版を用意する
数字や名詞を1つだけ替えた版を作り、元の版と同時に回して点数の開きを見ます。七角形なら八角形です。
4. 同じプロンプトを複数のモデルに投げて人の目で確認する
計算量の設定、所要時間、費用、何回目の試行かを記録します。出力は毎回ぶれるので、1回の結果で順位を決めません。自己申告は材料にとどめ、動画を複数回再生して破綻を探します。
まとめ
開発元が出す比較表の数値だけでは、自社で使うモデルを選べません。上位のモデルで差が出にくいことと、測定の条件で数値が動くことが理由です。
採点基準が公開されているお題を借りて、条件を入れ替えた版と一緒に複数のモデルへ投げると、その日のうちに比較できます。所要時間も記録すると、待ち時間が長いモデルを見分けられます。下位のモデルは問題が残っていても問題なしと報告するので、人の目で確かめる工程は省けません。
本記事は2026年9月時点の私の環境にもとづくもので、会社共通の仕組みでも、公式の推奨構成でもありません。採点は AI の判定を含むため、小さな差は読み取れません。
参考リンク
いずれも2026年9月26日に確認しました。


