
AIに開発を任せる形の提案を受けることがあります。指示を出しながらAIに書かせ、できたものを見てまた指示を出す進め方で、バイブコーディングと呼ばれます。短期間で動くものが出てくるので、発注する側から見ると魅力的に映ります。試作やデモならこれで構いません。困るのは、同じ進め方で業務に使うシステムを作る場合です。
バイブコーディングでは、次の3つをその場のAIの判断に任せています。どこまでできたら完成とするか、指摘をどこまで直したら終わりにするか、何を誰が確認したか、です。AIの出力は確率的に揺れます。同じ指示でも毎回少しずつ違うものが返り、レビューをさせれば毎回なにかしらの改善点を出します。この揺れを止める決まりがどこにもないまま、完成の判断までAIに寄っていくのが、バイブコーディングで業務システムを作るときの危うさです。
動いているように見えることと、業務で使えることは別です。後者を担保するには、AIに任せない部分を先に決めておく必要があります。
私の進め方
TAKTでフローを組む
私たちはバイブコーディングで開発を進めていません。私の場合は代わりに、TAKT というツールで開発のフローを組んでいます。
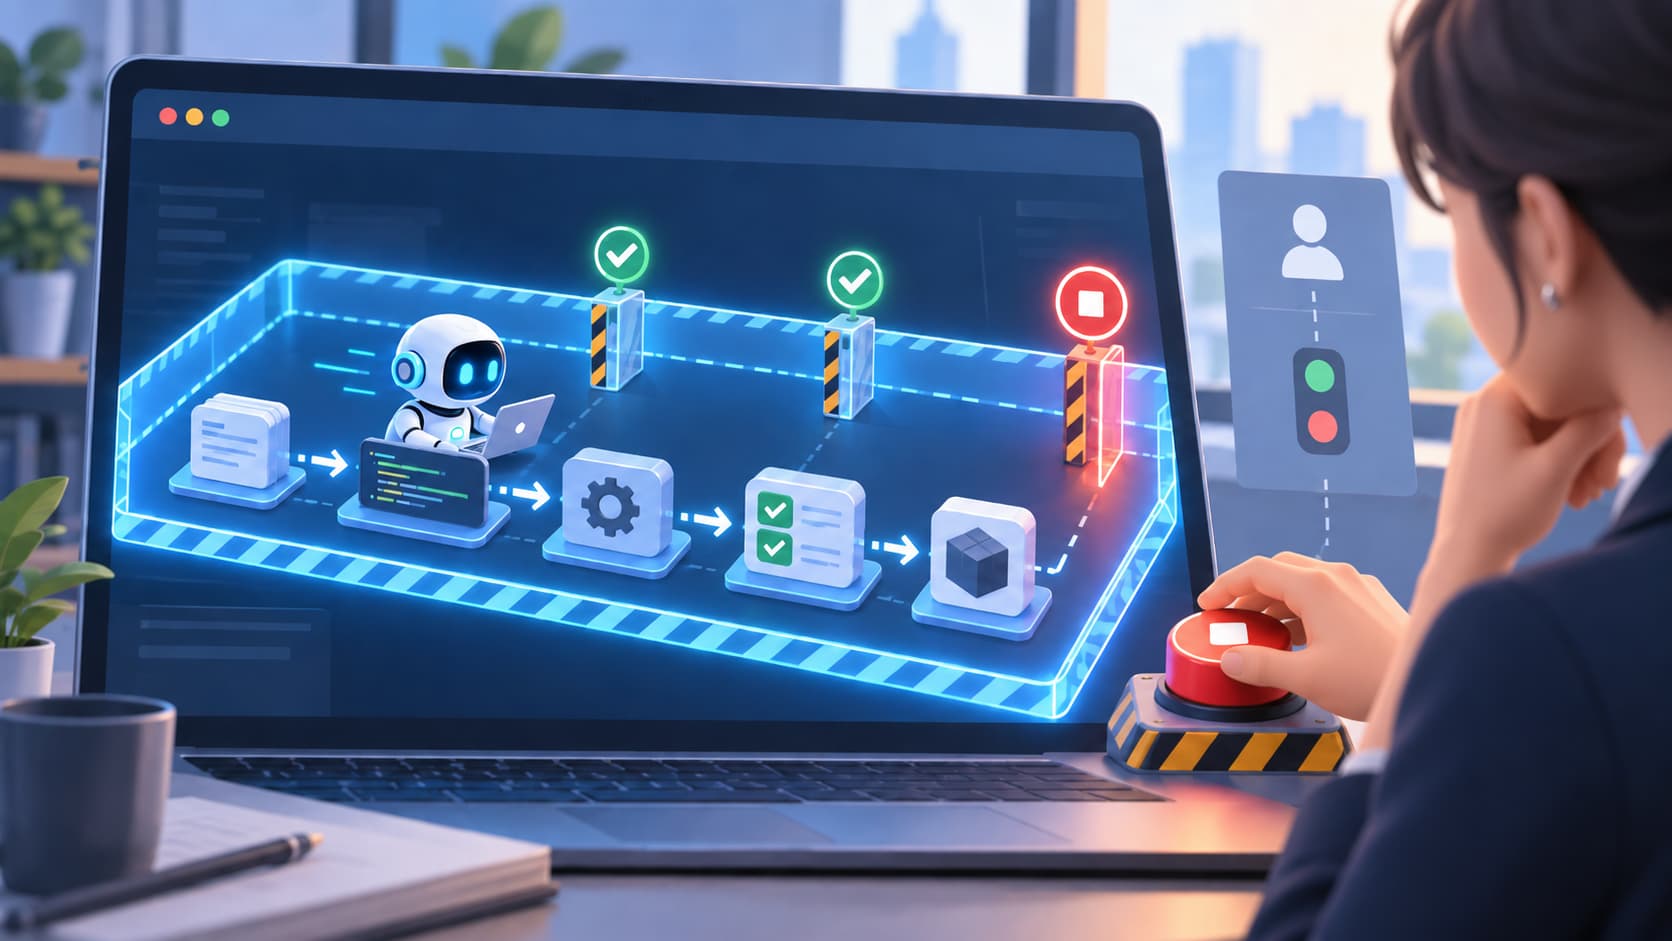
TAKTは、複数のAIエージェント(指示を受けて自分で手順を決めながら、ファイルを読みコードを書きテストを走らせるところまで続けて行うAI)に、決まった順番で作業をさせるためのツールです。どの段で何をさせるか、どの条件で次の段へ進むか、どこで止めるかを定義ファイルに書いておき、その通りに作業を流します。
社内ツールの改修用に組んだフローは12段です。計画、実装、レビュー3段、受け入れ確認を経て、プルリクエスト(書いたコードを本体に取り込む前に、差分をまとめて確認にかける手続き)の作成までを行います。役は7つに分け、コードを書けるのは実装と修正を担当する1つだけにしました。レビューを担当する役は、テストを走らせることはできてもファイルを編集できません。
人が判断する場所
人が入るのは2か所です。1つは受け入れ条件を確定する段で、何ができていれば完成とみなすかを、AIの案のまま進めずに人が決めます。ここをAIに任せると、その後のレビューの合否もAIが出した基準で判定されることになります。もう1つは、最後に本体のコードへ取り込む(マージする)段です。
加えて、レビューと修正の往復が決めた回数に達したら、そこで人に判断を戻すようにしています。
この進め方は速くありません。私の環境での試走では、1本あたり1時間弱から4時間20分ほどかかりました。人の確認待ちも入ります。バイブコーディングと比べれば、明らかに遅いです。
それでもこの形にしているのは、何が決まりで動き、何がAIの判断で動いたかを後から追えるようにして品質を担保したいからです。
確率で動く部分と決まりで動く部分
フローを組むときにいちばん気をつけているのは、AIに判断させる部分と、決まりで固める部分を分けることです。
| 部分 | 中身 | 性質 |
|---|---|---|
| AIに任せる | コードを書く、差分を読んで問題を探す、前提を疑う | 確率的に揺れる |
| 決まりで固める | 静的解析とテストの合否、どの役がファイルを編集できるか、往復を何回で打ち切るか、どこで人に戻すか | 同じ入力なら同じ結果 |
たとえばレビューの1段目は、静的解析(コードを動かさずに書き方の問題を機械で調べる検査)とテストの結果で機械的に判定します。AIの意見は入りません。2段目と3段目はAIに差分を疑わせますが、3段目だけは別の会社のAIに回しています。同じ系列のモデルで何度見ても、見落とす種類が重なると考えたためです。3段目まで到達した試走はまだないので、狙いどおりに働くかは確認できていません。
打ち切りの回数は、フローの外で機械的に数えています。AIに「もう十分直したか」を判断させると、終わりません。この点は次の節の記録がそのまま根拠になっています。
AIにフローを組ませて起きたこと
9本とも完走しなかった
実験として、このフローの外枠(どの段で何をさせ、どこで止め、誰に何を触らせないか)をAI自身に設計させ、そのまま9本流しました。9本とも完走していません。うち4本は実行環境の側で落ちたもので、フローの組み方とは別の原因です。残りの5本は、修正の段からの遷移での中止と、段の数の上限到達で止まりました。
止まり方の多くは「動かない」ではなく「終わらない」でした。AIが指摘を出し、別のAIがそれを直し、また指摘が出ます。ある1本では、2段目のレビューで出た指摘の件数が3件から8件に増え、8件が4回続き、4件に減ったあと7件に戻り、最後は5件でした。中身は毎回入れ替わっていて、同じ指摘の繰り返しではありません。別の日に回した5本のうち4本は、94分、16回から17回の段を回しても止まらないままでした。
抜けていたのは決まりの側
AIが組んだ外枠を見直すと、抜けていたのはすべて決まりで固めるべき部分でした。
レビューの合否は「問題がなければ次へ、あれば中止」という二択の文章で書かれていて、その判定をAIがしていました。AIのレビューはほぼ毎回なにかしらの指摘を出すので、この書き方では止める側にしか倒れません。TAKTを3種類のツールで回した別の方の事例でも、同じ形の二択の条件で仕様レビューが5回連続で中止になったと報告されています。どの程度の指摘なら先へ進めてよいかという閾値を、人が言葉で決めておく必要がありました。
往復を何回で打ち切るかも、どこにも置かれていませんでした。出口は「指摘が出なくなったら終了」だけで、上の記録の通り、その状態は来ません。
どちらも、AIの出力が揺れることを前提に、揺れを止める仕組みを外側に置く判断です。AIはそこを確率的な判断のまま残していました。
往復の回数に予算を設けてフローの外で数えるように直したあと、通し実行はまだ完了まで確認できていません。直した結果が十分かどうかは、この記事の時点では分かっていません。
切り分けに経験が要る理由
ここからは記録ではなく、私の見解です。
どこを決まりで固めるかは、開発の現場でどこが壊れやすいかを知っていないと決められません。テストで何が保証できて何が保証できないか、レビューの指摘のうちどれが止めるべきものか、修正が別の箇所を壊したときにどう気づくか。こうした判断は、実際にシステムを作って運用し、事故を経験してきたエンジニアの知識に依っています。
今回の試走では、AIに外枠を組ませると、この切り分けそのものが確率的な判断のまま残りました。1回の実験なので一般化はできませんが、少なくとも私の環境では、AIに任せて業務で使える水準のフローはできませんでした。AIを使う開発であっても、フローを組むところには熟練のエンジニアが要る、というのが今の私たちの考えです。
発注時に確認する項目
AIを使った開発の提案を受けたときは、成果物の見せ方より、次の点を聞くほうが早いです。
- AIに判断させている部分と、テストや機械的な検査で合否を決めている部分がどこか
- レビューと修正の往復を何回で打ち切るか、打ち切ったら誰に戻すか
- 完成の基準(受け入れ条件)を誰が確定するか
- そのフローを誰が組んだか
これらに具体的な答えが返ってこない場合、実態はバイブコーディングに近いと考えてよいと思います。作業時間は流してみるまで読めず、完成の判断もAIの側に寄ります。
まとめ
バイブコーディングは、完成の基準と終わりの条件をAIの判断に預ける進め方です。AIの出力は確率的に揺れるため、業務で使うシステムをこの進め方で作るのは危ういと私たちは考えています。
私たちはTAKTで開発フローを組み、AIに任せる部分と決まりで固める部分を分けています。受け入れ条件の確定と最後のマージには人が入り、往復の回数はフローの外で数えます。そのぶん時間はかかり、1本あたり1時間弱から4時間20分ほどの幅がありました。
AIにこのフローの外枠を組ませた実験では、9本とも完走しませんでした。抜けていたのは、揺れを止めるための決まりの側です。この切り分けには、開発の現場で何が壊れるかを知っているエンジニアの判断が要ります。
記載した構成と数値は2026年9月時点の私の環境での試走にもとづくもので、会社共通の仕組みではありません。ツールの更新が速いため、設定の項目名は変わることがあります。
参考リンク
- TAKT(2026年9月26日確認)
- TAKT の日本語README(2026年9月26日確認)
- TAKT のワークフロー定義(2026年9月26日確認)
- takt で複数のAIコーディングエージェントを回した事例(2026年3月26日公開 / 2026年9月26日確認)
- 止まり方の内訳と設定項目の一覧は Zenn に掲載しています。


