AIの周辺技術は、社内に定着する前に入れ替わります。「ステップバイステップで考えて」と思考の手順を指示する書き方は、2023年ごろに有効な手法として広まり、私も当時はそう扱っていました。ところがOpenAIは推論モデル向けのガイドで、推論モデルには思考の手順を指示するプロンプトは不要で、場合によっては出力の質を落とすと書いています。
これらをすべて学ぶ負担は研修、採用、技術選定に出ます。作った研修資料は中身が古くなるたびに作り直しになり、求人票に書いた要件も書いた時点の前提のまま置いておけなくなります。選んだライブラリやAPIが廃止されれば、動いているものを作り直すことになります。
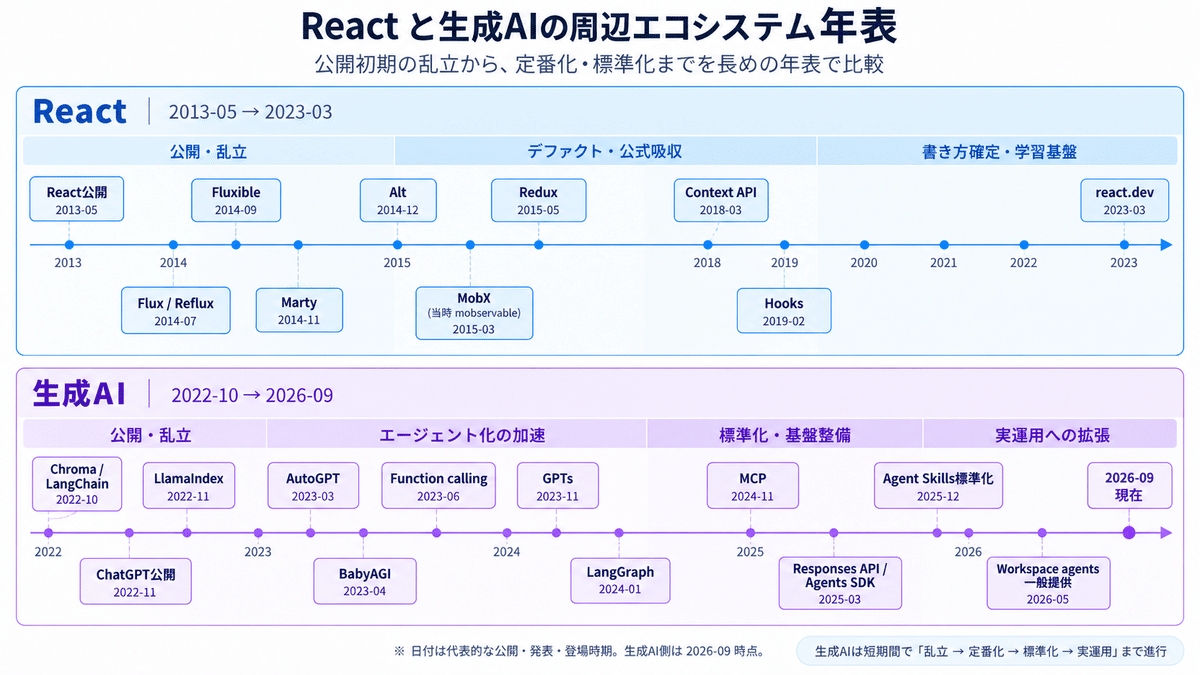
私は、何に投資するかの判断を、React黎明期の年表と並べて整理しました。2013年ごろからReactを見ていて、Fluxを追い、Hooksで書き方が落ち着くまでを通っています。社会に広がる範囲は生成AIのほうが広いものの、技術が固まるまでの過程は重なります。
結論
Reactと生成AIの年表を2本作り、転換点の間隔、消えたものと残ったもの、必要とされるスキルの変化を比べました。
結果的に作った判断基準は次のとおりです。
- 具体実装の暗記に投資しない。落ち着くまでは消えるのが速い
- 責務分担の設計と、AIに渡した作業を検収する力に時間を割く
- 道具の採否は、公式かどうかではなく、そのベンダーが維持し続ける経済的な理由があるかで見る
歴史
React黎明期と生成AIで一致する転換点
どちらの年表にも、デファクトが決まる時点と、書き方が決まる時点があります。生成AI側は間隔が短く、デファクト確定までが2.0倍、書き方の確定までが1.9倍、公式が周辺の機能を吸収するまではReactの58ヶ月に対して7ヶ月で8.3倍の速さです。期間は私が作った年表にもとづく計算で、乱立期の始まりとLangChainがデファクトになった年は公式の日付が取れないため、調べたうえでの私の判断です。
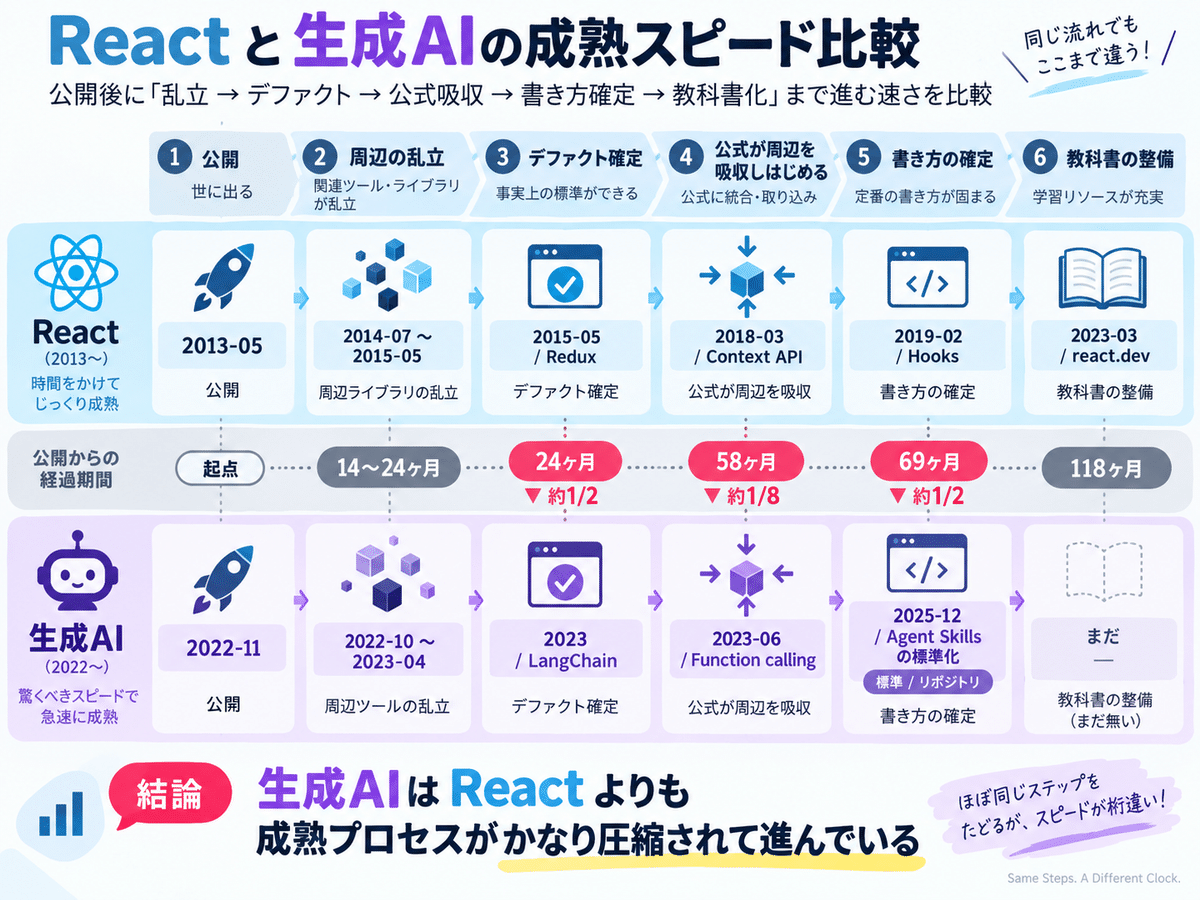
ChatGPTの公開から5.5ヶ月後の2023年5月15日には、日立が専門組織を立ち上げています。React側で日本企業が本格着手した時期は、業界統計が見つからず数字を置けませんでした。
個人の工夫を公式が吸収するまでの流れ
穴を先に埋めるのは個人や外部の開発者で、あとから公式が取り込みます。Reactで外部に置かれていたアプリ全体の状態の管理は、Fluxの実装が2014年に何本も並んでReduxが本命になったあと、Context APIとHooksとしてReact本体に入りました。
生成AI側も順番は同じで、モデルの出力を自分で解析して分岐を書いていた処理をLangChainがまとめ、2023年6月にFunction callingが公式のAPIに入りました。関数の形を渡すとモデルが引数のJSONを返すため、解析を自前で書く必要がなくなりました。個人が埋めた部分は、公式に吸収されると覚える対象から外れます。
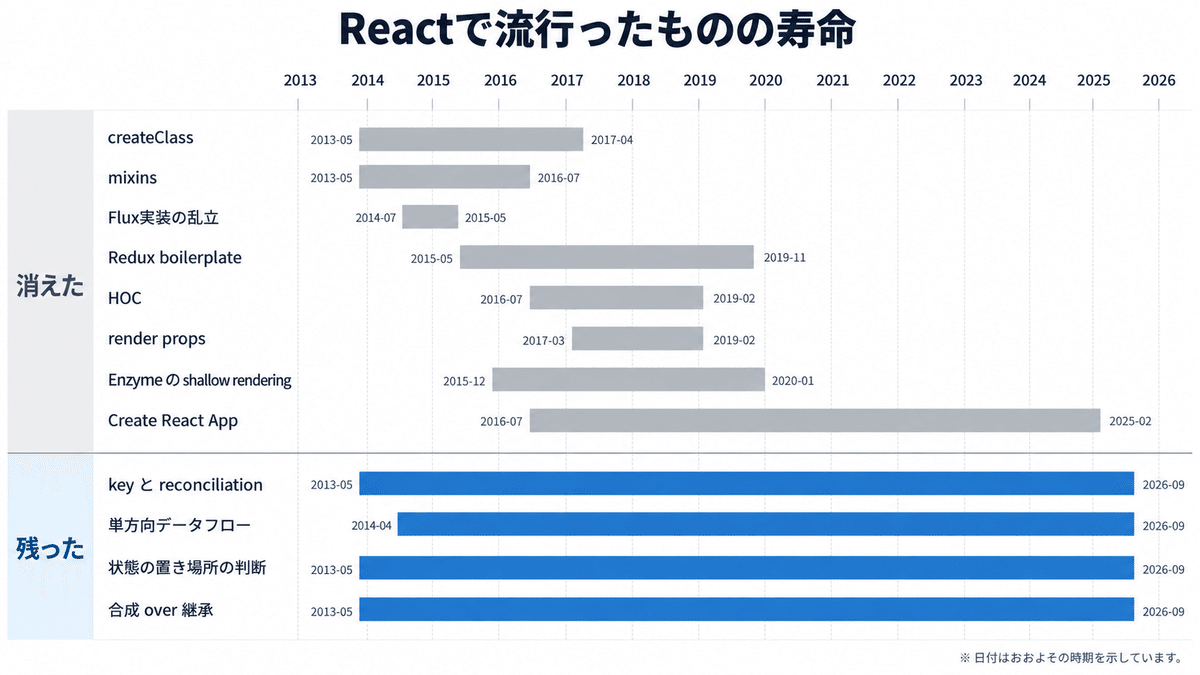
消えた具体実装と残った概念の分かれ目
消えたのは、当時の不足を埋めるための具体実装です。Reactのmixinsと高階コンポーネントは、どちらもロジックを使い回す手段がなかったことへの対処でした。残ったのは依存関係の整理の仕方そのもので、key propは2013年から13年、再レンダー(画面を作り直す処理)の間でリストの要素を同定する問題を解き続けています。
生成AI側も分かれ方が同じです。思考の手順を書かせる定型句やfew-shot(見本をいくつも添える書き方)の大量添付は、モデルが指示を追えなかったことへの対処で、モデルが強くなると消えました。残っているのは、コンテキストの設計やeval(出力を一定の基準で採点する仕組み)のような抽象度の高い概念です。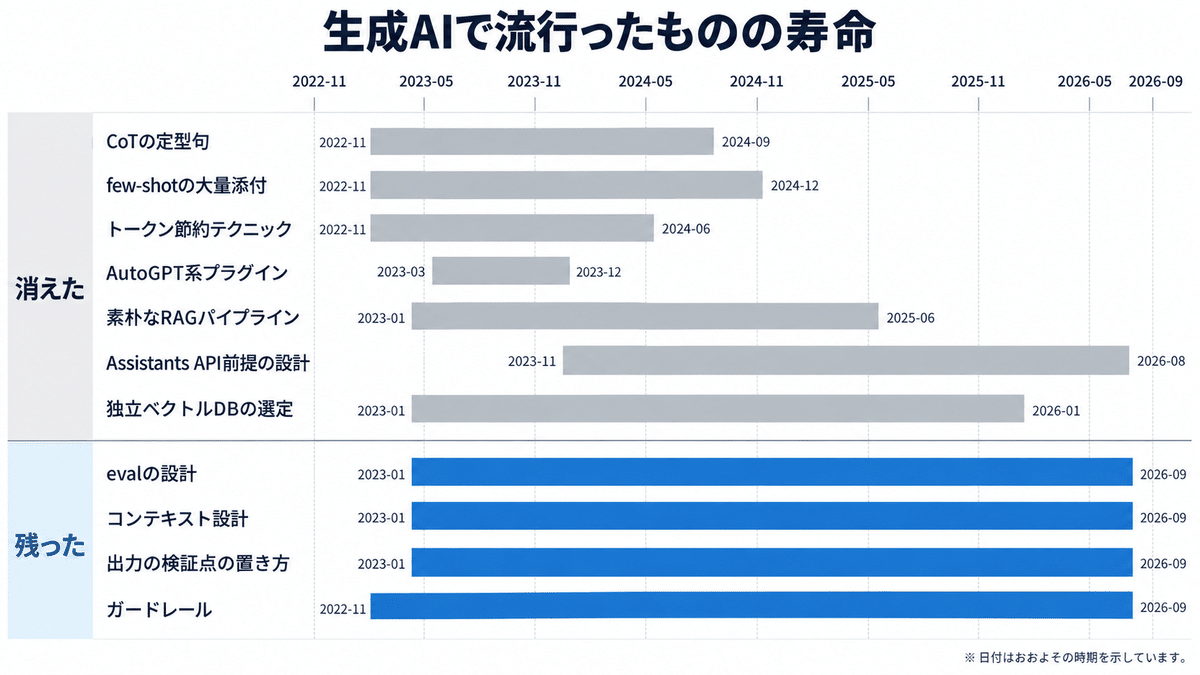
ライブラリとAPIの採否で見るベンダー側の維持理由
公式が作ったかどうかは、生き残りの根拠になりません。Facebook発のRecoilは2025年1月にアーカイブされ、公式ツールだったCRAも2025年2月に終了しました。一方でReact Router、Redux、React Queryは外部で作られて残っています。
OpenAIのAssistants APIが2025年8月に廃止を通知され、2026年8月に停止したのも同じ見方で説明がつきます。採否を決めるときに見るのは、そのベンダーがそれを維持し続ける経済的な理由があるかどうかです。
Reactと同じには扱えない生成AI側の条件
情報の追い方はReactのときの方法が流用できますが、前提が違う部分があります。
出力が再現しません。Reactは同じ入力から同じ画面が出るので、再現手順を書けば誰の手元でも同じ結果になりました。生成AIはtemperature(出力のばらつきを決める設定)を0にしても揃わず、Thinking Machines Labの検証(2025年9月)では、Qwen3-235Bに同じ入力を1000回投げて80種類の出力が出ています。
Reactが変えたのはフロントエンドの書き方でしたが、生成AIは提案書の作成から仕訳、書類選考まで入ります。情報の出どころもエンジニア以外に広がりました。
モデルを作る側には資本と物理の制約もあります。Reactはnpm(部品を公開して配る仕組み)に公開すれば誰でも参加できましたが、フロンティアモデルを作れるのは、GPUとデータと電力の費用を出せる企業だけです。学習データも有限で、Epoch AIの推定(2024年6月)では、人間が書いた公開テキストを2026年から2032年のどこかで使い切るとされています。
具体的な使い方
新しいモデルが出てから採用を決めるまでの一周
新しいモデルやツールが出たときは、公式のリリースノート、deprecation(廃止予定の告知)のページ、モデルカード(性能と制限をまとめた公式資料)から読みます。次にキュレーターの検証記事で、他の人が何を測ったかを見ます。ここで候補に残ったものだけを自分の実タスクに入れて、業務で使う条件のまま小さく比べます。
入れ替えると決めたら、モデルを呼ぶ部分を差し替えて、書き方の細部は覚えずに、責務分担が崩れていないかのレビューに時間を回します。維持し続ける経済的な理由が見えない道具は採用しません。
学習に時間を割く対象の切り分け
APIのシグネチャ(関数の名前と引数の並び)や正規表現の書き方のような細部を学習することはあまり必要なくなりました。AIが書くため、覚えていなくても手が止まりません。何も見ずに書ける状態までは要らないという意味で、仕様を知らなくてよいという意味ではありません。
時間を割いているのは、状態をどこに置くか、どこでデータを取るか、どの単位で分割するかという設計の判断です。React黎明期にできる人を分けていたのはライフサイクルメソッドの呼ばれる順番のような仕様の暗記でしたが、その多くはHooksやReact CompilerでReact側に吸収されました。私の仕事では、細かい仕様を覚えている出番が減り、設計を見る時間とAIの出力を検収する時間が増えています。
AIが書いたコードをレビューするときの見どころ
生成AIを使う場合、今までよりもシステムの責務分担から外れていないかを見る必要があります。AIはファイル単位や関数単位ではかなり正確に書きますが、どこに何があるべきかは渡したコンテキストの範囲でしか判断しません。
例えばAPI呼び出しを1か所に集めてエラー処理と再試行を統一している場合に、画面の改修を頼むと、画面の側で直接通信を書いた状態で返ってくることがあります。テストは通り画面も動くため差分だけでは問題に見えませんが、放置するとエラー処理の経路が2本になります。レビューで見る対象が、コードの正しさから責務分担の維持に移りました。
AIに作業を渡すときの決めごと
人に仕事を任せるときと同じ項目を決める必要があります。
- 仕事を切る。1回の依頼の範囲を、1つのプルリクエスト(変更をまとめてレビューに出す単位)としてレビューできる量までに絞る
- 必要な情報を渡す。設計の方針、命名の決まり、変更してはいけない場所を、AIが毎回読む指示ファイルに置く
- 権限を決める。エージェントに実行を許すコマンドと、本番環境や秘密情報へのアクセスを、設定ファイル側で制限する
- 検収する。出てきた変更を自分の手元で動かして確かめる
- 止める。壊す操作の前に人の確認を挟み、基準に合わないものはCI(自動でテストを走らせる仕組み)で落とす
権限設計と監視をやってきた人の経験が生きる箇所です。
モデルの差し替えを前提にした設計の決めごと
モデルを呼ぶ部分は差し替えられる形にしておきます。価格改定やローカル推論への移行に備えるためです。
出力が揃わないことと、モデルの更新でエラーを出さずに出力の形式が変わることは、業務プロセス側で受ける前提にしました。Reactでは非推奨の警告が出て数年の猶予があって削除される順番でしたが、生成AIでは警告を待つ運用が成り立ちません。
推論のコストとレート制限(単位時間に呼べる回数の上限)は、運用で見て調整する形から、設計を決める段で制約として置く形に変えました。実際にモデルを入れ替えて、直す範囲が呼び出し部分で収まるかは確かめていません。性能の伸びが鈍る可能性と、提供方法に規制がかかる可能性も私の推測です。
生成AI周辺の情報の追い先の絞り方
追う先は、少数のキュレーター、公式の一次情報、自分の実タスクでの検証に限ります。生成AI側の整理に使ったのはSimon Willisonのブログ、Anthropicのengineeringブログ、ハーネス(AIに道具と情報を渡す土台)の整理はBöckelerの記事です。公開情報に出にくい失敗談は勉強会で拾っています。
速報はXに先に出ますが、目的の情報を選ぶ手間がかかります。
リークされたシステムプロンプトを集めたリポジトリも材料で、2026年9月時点で14万スターを超えています。読むと、作り手が何を禁止して何を優先したかが分かります。React黎明期にissue(リポジトリ上の課題の記録)の長いコメントを設計文書の代わりに読んでいたのと同じ方法です。
まとめ
React黎明期と並べると、生成AIでは個人の工夫を公式が吸収する流れと、具体実装が消えて概念が残る分かれ方が共通していて、生成AI側はその周期が数倍速いです。
投資先として残すべきは、責務分担の設計と、AIに渡した作業を検収する力です。道具の採否は、公式かどうかではなく、維持し続ける経済的な理由があるかで判断しています。モデルを呼ぶ部分は差し替えられるようにし、レート制限とコストは最初から設計の制約として置きます。
出力が再現しないこと、影響する業務が広いこと、モデルを作る側の資本と物理の制約は、Reactの経験が流用できない部分です。
記載した年表と数値は2026年9月時点で確認したもので、React側の当時の空気は私の記憶にもとづきます。生成AI側の数字は変わります。
参考リンク
いずれも2026年9月26日に確認しました。


